Herramienta de lingüística del corpus
Hace ya más de 20 años, estudié algo de programación en Perl para crear unos programitas que analizaran un corpus paralelo de obras literarias japonesas y sus traducciones al español. Leandro Llanza González me ayudó a resolver algunas cuestiones técnicas que se me escapaban. Estos programas formaron parte de mi tesis de magíster en la Universidad de Tokio, pero se quedaron acumulando polvo cibernético por falta de uso. Hoy, con la ayuda de Gemini y Claude, los he logrado revivir, mejorar y ampliar para crear esta herramienta de análisis que les comparto. Ahora está en Python, que es lo que la lleva hoy en día para el procesamiento de lenguas naturales. Espero que algún interesado la pruebe y me comente qué tal. Puede servir para analizar cómo se tradujo tal cosa, encontrar colocaciones, comprobar construcciones gramaticales, etc. Quizás falten algunas instrucciones, pero ya me lo harán saber y lo iremos mejorando.
La herramienta permite consultar dos corpus: uno bilingüe, integrado por 19 obras japonesas y sus traducciones al castellano, y otro monolingüe, compuesto por nada menos que 945 textos originales en japonés procedentes de Aozora Bunko. Los textos de este último pueden filtrarse por autor y obra.
Un ejemplo de aplicación consiste en comparar la frecuencia de uso de los pronombres personales de primera persona en ambos idiomas. Aunque se dice que el japonés omite el sujeto y tiende a no usar pronombres, nos llevamos una sorpresa al revisar el corpus bilingüe.
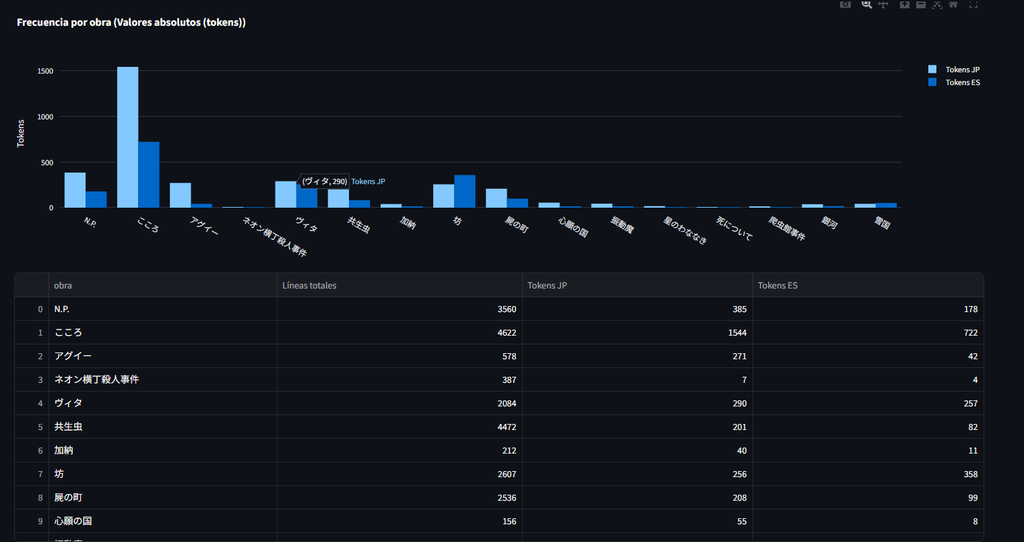
Las imágenes muestran los resultados de buscar las distintas versiones de lo que equivale al pronombre de primera persona singular, en posición de sujeto o tópico “私が,わたしが,わたくしが,ぼくが,僕が,俺が,おれが,私は,わたしは,わたくしは,ぼくは,僕は,俺は,おれは”, y nuestro único “yo” en español.
Abajo tenemos vista general de la frecuencia de resultados por obra. En la mayoría de las obras, el uso de pronombres en japonés supera al del español. (Se ve como las pelotas, pero pueden recrearla en la herramienta, marcando la casilla de “Búsqueda léxica tradicional / 語彙検索” y poniendo los pronombres arriba indicados).
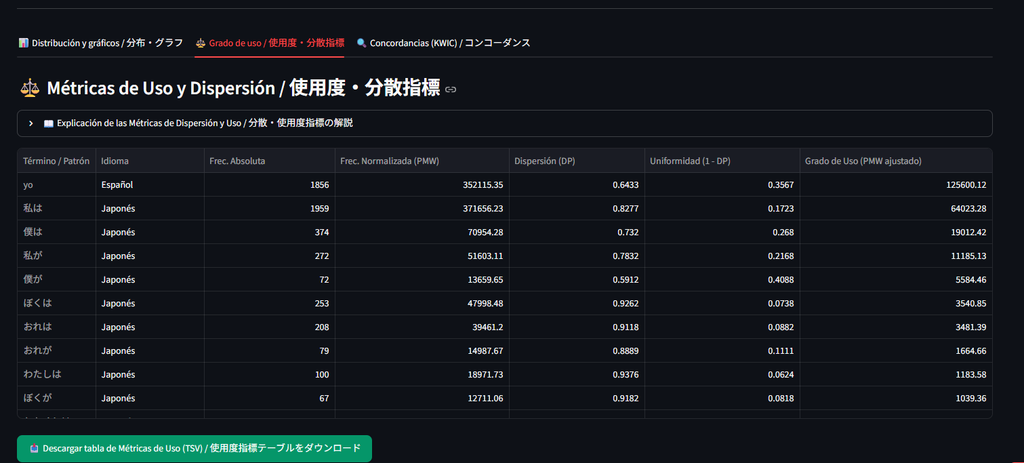
La segunda imagen muestra el grado de uso para cada pronombre, tanto en términos numéricos absolutos como normalizados en palabras por millón (PMW), es decir, cuántas veces aparecería el término en un millón de palabras.
La tercera imagen corresponde a los ejemplos concretos encontrados, separados entre aquellos en que el pronombre está presente en ambos idiomas y aquellos en que aparece ya sea solo en japonés o solo en español. Mirando los ejemplos, podemos hacernos una idea de cuáles son los mecanismos de cada lengua para expresar el significado pronominal en cada caso: el pronombre equivalente, solo la conjugación verbal, el contexto situacional o sintáctico, etc.
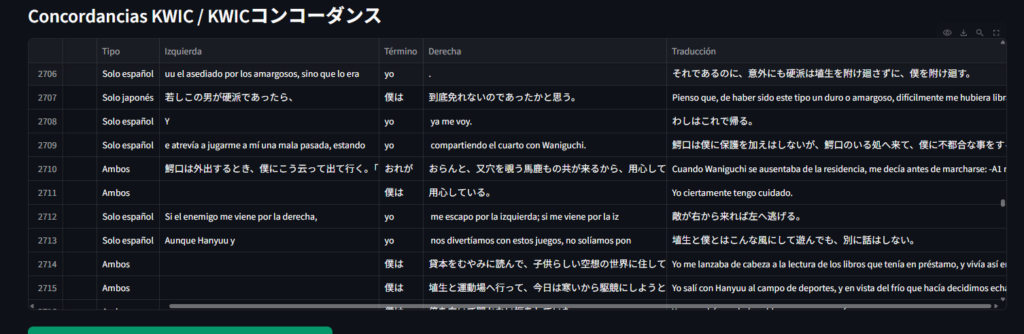
Esta última también nos permite revisar caso a caso y detectar los que se escapan al análisis original, como ver que dejamos fuera el pronombre わし (línea 2708) o que con las partículas とは también se incluyen casos en que se usa como sujeto (línea 2713).
Naturalmente, con estos datos no podemos afirmar categóricamente que el japonés use más pronombres que el español, puesto que es un corpus pequeño, formado únicamente por obras literarias japonesas y sus traducciones. Además, hay otros factores en juego, como el registro, ya sea oral o escrito, la temática, etc. Sin embargo, nos enseña que las cosas no son siempre como se suele decir y que no debemos darlo todo por sentado…aunque tu amigo japonés te diga que los pronombres casi no se usan.
Además, si quisiéramos hacer un estudio más serio, habría que incorporar también la presencia de otras formas pronominales en español y sus equivalentes en japonés con la partícula correspondiente (mí y 私に…; mi y 私の, etc.). En realidad, son varias y complejas las combinaciones posibles para tener la película más clara.
Quedan invitados a probar la herramienta a ver qué pasa con la segunda persona o probar cualquier otra cosa que se te venga en mente…y a compartir tus resultados, claro.
Otro día les muestro otro tipo de búsqueda, para que se entusiasmen.
Nota 1: Los datos se pueden descargar en formato tsv. Para verlos bien en Excel sin que se corrompan las letras en japonés, (文字化け), conviene abrir un Excel nuevo y en la pestaña Datos, importar desde De texto/CSV.

También te puede interesar

Dificultades del japonés IV: los homófonos

El idioma japonés, según Haruhiko Kindaichi (日本語, 金田一 春彦)
